11בניית אתרים ונכסים דיגיטלייםתרבות ובילוי
תקופת האוספים
ארכיון האוספים שיצאו בישראל
osafim-archive.pages.dev
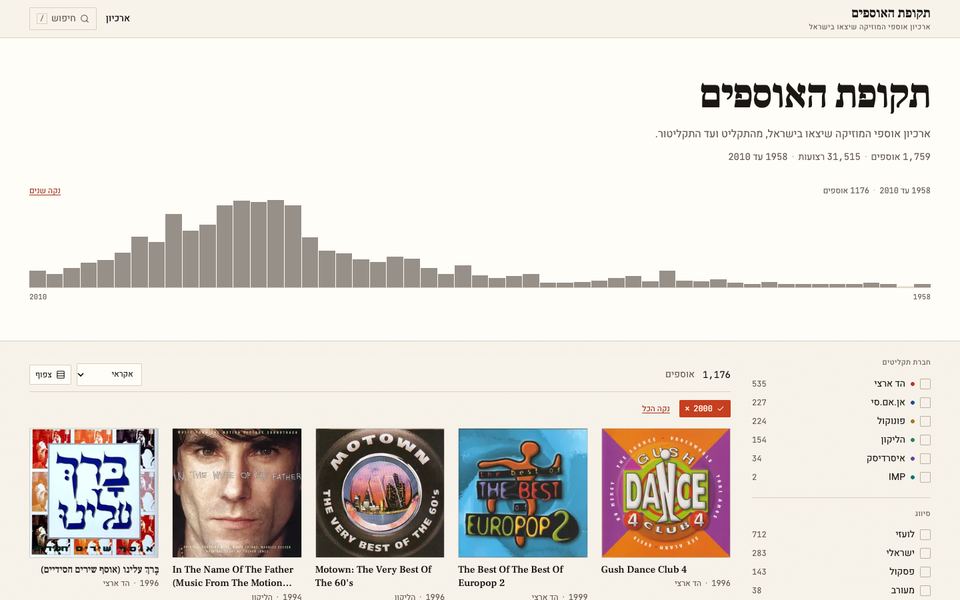
ארכיון בעברית של אוספי המוזיקה שהוציאו חברות התקליטים הישראליות, מ 1958 ועד 2010, שבו אפשר לחפש שיר ולגלות באיזה אוסף הוא הופיע.
1,759 אוספים ו 31,515 רצועות משש חברות תקליטים, באוויר ופתוחים לחיפוש
האתגר
מי שגדל על "סופרמיקס" ועל אוספי הלהיטים של הד ארצי, אן.אם.סי, פונוקול והליקון מחפש היום שאלה אחת: באיזה אוסף היה השיר הזה. המידע קיים, אבל מפוזר: בבלוג אספנים ותיק שנכתב ב Word והודבק לרשת, בערוץ יוטיוב, ובמאגר הבינלאומי Discogs. כל מקור כותב את שמות הסדרות אחרת, בעברית או באנגלית, ואף אחד מהם לא עונה על השאלה הזאת בחיפוש אחד.
מה עשיתי
- בניתי קודם אינדקס, ורק אחר כך אתר. שאלה על רשימת שירים היא שאילתת מסד נתונים, לא שאלת זיכרון. משכתי את 547 הפוסטים של הבלוג ואת 125 הסרטונים של הערוץ, ופרסרתי HTML שבור: תגיות באמצע מילים ושורות שנשברו באמצע רצועה.
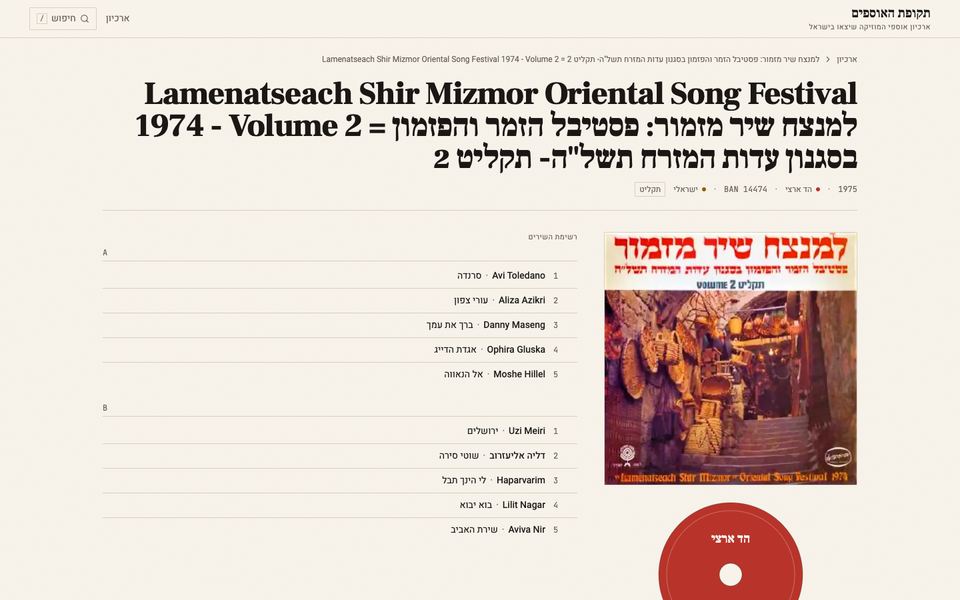
- סרקתי את הקטלוגים של חברות התקליטים הישראליות ב Discogs, 20,060 הוצאות, כדי למצוא את האוספים שאינם בבלוג. משם מגיעים באתר שמות האוספים, השנים, המק"טים, רשימות השירים והעטיפות, והבלוג משלים את מה שאין שם: הקרדיטים.
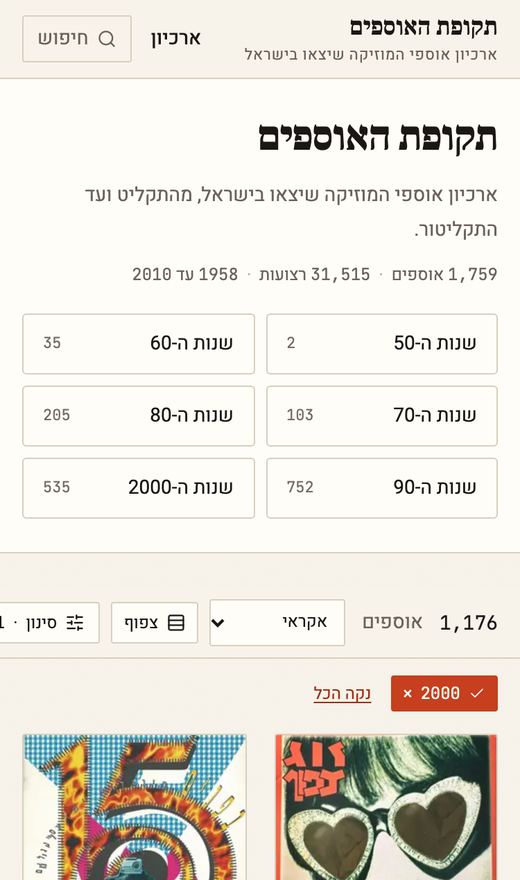
- בניתי את האתר: רשת עטיפות, עמוד לכל אוסף עם רשימת השירים לפי צדדים או דיסקים, חיפוש אחד שמחפש בו זמנית אוספים, שירים ואמנים, וסינון לפי עשור, חברה, סיווג ופורמט, שנשמר בכתובת כדי שאפשר יהיה לשתף. שלד התצוגה נבנה בכלי AI לבניית אתרים, והנתונים, הסינון והתיקונים לנייד הם עבודה שלי מעליו.
- כתבתי דף מקורות ישר: מאיפה כל שדה מגיע, מה לא אומת מול העותק הפיזי, שהסיווג ללועזי, ישראלי, פסקול ומעורב מחושב ואינו חף מטעויות, ושמי שמחזיק בזכויות בעטיפה יכול לבקש להסיר אותה.
ההחלטה שעשתה את ההבדל
טבלת תעתיק אחת בין עברית לאנגלית, שכל הכלים משתמשים בה. הבלוג כותב "500% פיור דאנס" ו Discogs כותב "500% Pure Dance". בלי גשר ביניהם, כל סדרה כזאת נספרת כחסרה, החיפוש של "סופרמיקס 4" לא מוצא את "SuperMix 4", והסרטון לא מוצמד לאוסף. החלטתי שההתאמה הזאת היא תשתית ולא תיקון נקודתי, ושקישור ליוטיוב מופיע רק כשיש התאמה ודאית לפי שם הסדרה, מספר החלק והשנה. הסיבה: בארכיון לאספנים, קישור שגוי אחד מבטל את האמון בכל השאר.
מה עשה ה AI, ומה נשאר אצלי
- ה AI עשה את העבודה הכבדה בנתונים: כתב את הפרסור שמחלץ רצועות מתוך HTML שבור של 547 פוסטים, משך את הקטלוגים ובנה את שלד התצוגה. בנוסף בניתי סוכן AI שעונה על השאלה "באיזה אוסף היה השיר הזה".
 אני קבעתי שהסוכן לא עונה מהזיכרון, וזו הייתה ההחלטה החשובה: הוא חייב לשאול את האינדקס, כי שאלה על רשימת שירים היא שאילתת מסד נתונים ולא שאלת ידע. קבעתי גם שקישור ליוטיוב מופיע רק כשההתאמה ודאית, ושדף המקורות אומר בגלוי מה לא אומת.
מה יצא
- 1,759 אוספים ו 31,515 רצועות, משש חברות תקליטים, מ 1958 ועד 2010.
- קרדיטים של עורך מוזיקלי, מפיק ומיקס בכ 350 אוספים, מתועדים מהעותקים הפיזיים, ומסומנים בדף האוסף.
- 85 אוספים מקושרים לסרטון שלהם ביוטיוב.